Module 3 練習講義 — Scrape Playground 與 AI Agent 網頁擷取
本講義對應 module03-playground/,把本機網站操作、資料擷取與 Codex Skill 封裝串成一條可自學的流程。重點不是「背 API」,而是練習如何指揮 AI Agent 觀察畫面、選擇策略、保存資料、驗證結果。
本練習場刻意包含弱密碼、固定 token、可略過登入等不安全設定,只能在本機 127.0.0.1 練習,不可部署到公開網路。
如何使用本講義
| 對象 | 建議用法 |
|---|---|
| 現場學員 | 跟著講師逐關操作,先用瀏覽器看畫面,再請 Codex 操作與驗證。 |
| 課後自學 | 從啟動網站開始,至少完成練習 1、2、4 與 Skill Replay,進階再做練習 5。 |
| 帶領講師 | 可先投影投影片模式,再切到講義模式展示 prompt、預期產物與檢核方式。 |
每個練習固定包含:目標 → 動手做 → 預期結果 → 想一想 → 驗收。請要求 Agent 每次都回報它讀到的欄位、列數與保存路徑。
練習前準備
啟動指令
cd module03-playground
SCRAPE_PLAYGROUND_OPEN_BROWSER=0 .venv/bin/python app.py
若沒有既有虛擬環境,可先安裝相依套件:
python -m venv .venv
.venv/bin/pip install -r requirements.txt
確認服務
curl -I http://127.0.0.1:5000/public/buttons/
curl -fsS "http://127.0.0.1:5000/public/roster.csv?course=datastruct" | sed -n '1,5p'
CSV 前幾列應看到 student_id,name,class_name,且中文姓名與班級不是亂碼。
講師提示:先讓學員知道這是一個本機服務,不是公開網站。Agent 可以操作瀏覽器,也可以在必要時用 terminal 驗證端點。
練習 0 — 任務地圖與關卡階梯
目標:先把每一關對應到一種網頁障礙,讓後面的操作有清楚判斷依據。
| 練習 | 起點 | 要練的能力 |
|---|---|---|
| 練習一:公開名冊(按鈕選課) | /public/buttons/ | 點按鈕、下載 CSV、保存到 data/ |
| 練習二:公開名冊(下拉選單) | /public/ | 操作 select、比較同一資料不同入口 |
| 練習三:登入牆 | /login → /l2/dashboard | 登入後擷取受保護表格 |
| 練習四:深層導覽 + 搜尋 | /l3/courses | 課程 → 場次 → 點名,輸入正確日期才出現資料 |
| 練習五:分頁 / AJAX | /l4/attendance?page=1 | 逐頁收集或使用 /api/l4/rows |
| 練習六:JS 動態渲染 | /l5/ | 原始 HTML 無表格,需瀏覽器渲染或呼叫 /api/l5/data |
想一想
- 如果 Agent 只用
curl抓原始 HTML,哪些關卡會失敗? - 如果網站有穩定 CSV 或 JSON 端點,什麼時候可以不用真的點完所有畫面?
練習 1 — 公開名冊:按鈕選課與 CSV 下載
第一關的重點是讓 Agent 先看畫面,再找出穩定下載連結。The first level asks the agent to inspect the page, then identify a stable download link.
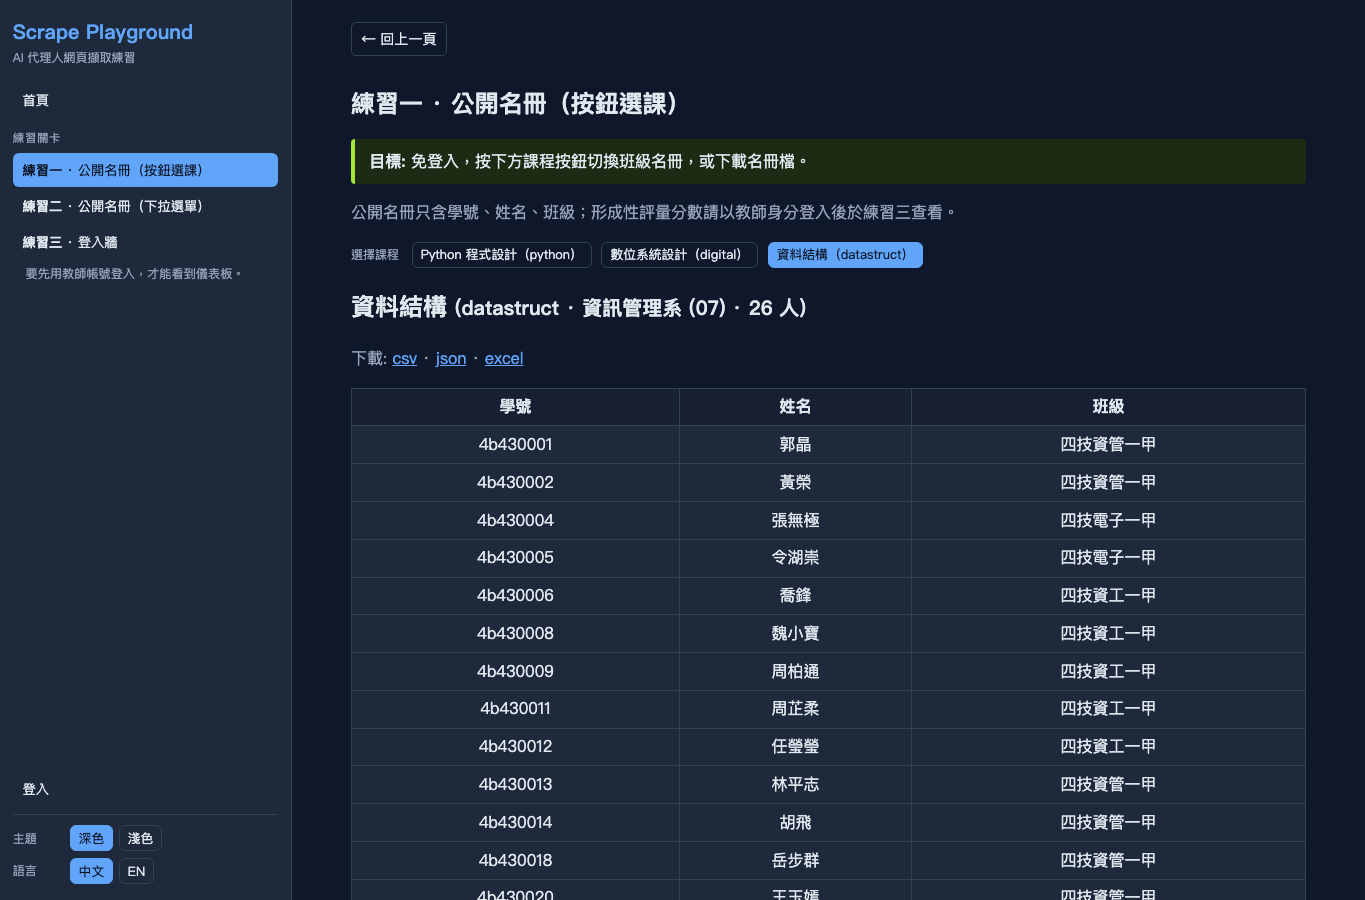
目標:請 Codex 操作 Practice 1,選擇指定課程,下載名冊 CSV,並保存到專案的 data/ 資料夾。
動手做
在 Codex 對話中貼上:
請開啟本機 Scrape Playground,進入「練習一 · 公開名冊(按鈕選課)」。
請選擇「資料結構(datastruct)」課程,下載 roster CSV。
下載後請把檔案保存到目前專案的 module03-playground/data/datastruct.csv,
並驗證 CSV 欄位、前 5 筆資料與頁面表格一致。
預期結果
- 頁面切到
/public/buttons/?course=datastruct。 - CSV 下載連結是
/public/roster.csv?course=datastruct。 - 專案中出現或更新
module03-playground/data/datastruct.csv。 - 檔案欄位為
student_id,name,class_name。
直接驗證指令
curl -fsS "http://127.0.0.1:5000/public/roster.csv?course=datastruct" \
  -o module03-playground/data/datastruct.csv
sed -n '1,6p' module03-playground/data/datastruct.csv
想一想
- Agent 是先找按鈕、再點下載,還是直接推導 CSV URL?哪一種比較適合教學?
- 如果 UI 文字切成英文,
?course=datastruct與 CSV 欄位 key 會不會改變?
練習 2 — 登入牆:受保護資料與 Session
目標:讓 Agent 完成登入,取得登入後才可見的成績表,並能說清楚「公開資料」與「受保護資料」的差異。
動手做
請登入 Scrape Playground 的教師帳號 yang1234,密碼 1234。
登入後進入「練習三 · 登入牆」,選擇 datastruct 課程。
請擷取成績表,存成 module03-playground/data/datastruct-grades.csv。
完成後請回報欄位名稱、資料列數,以及平均分數欄位是否存在。
也可使用新手捷徑確認 session 概念:
http://127.0.0.1:5000/auto-login/yang1234?token=DEMO預期結果
- 未登入直接開
/l2/dashboard會回到登入頁。 - 登入後可看到形成性評量分數、平均與總成績。
- Agent 應保存成績 CSV,並驗證列數與欄位。
想一想
- 名冊資料為什麼可以公開,成績資料為什麼要登入?
- 如果 Agent 要操作真實校務系統,你會要求它在哪些步驟先停下來讓人確認?
練習 3 — 深層導覽 + 搜尋條件
目標:請 Agent 從課程列表逐層進入點名頁,找到正確場次日期,輸入日期後才擷取表格。
動手做
請從 /l3/courses 開始,進入 Python 課程的上課場次列表。
請選一個場次,先記下該場次日期,再進入點名頁。
在搜尋框輸入完全相同的日期,顯示點名表格後,存成 data/python-attendance-one-session.csv。
請回報你選的 session id、日期、欄位名稱與列數。
預期結果
- Agent 不能只停在「尚未顯示資料」狀態。
- 必須從場次列表取得正確日期,並在點名頁輸入相同日期。
- 輸出的 CSV 至少包含學號、姓名、出席狀態等欄位。
想一想
- 為什麼「看得到頁面」不代表「資料已經顯示」?
- Agent 應該如何記錄它在多層頁面中取得的中間線索?
練習 4 — 分頁 / AJAX:逐頁彙整全部列
目標:讓 Agent 認出頁面只顯示部分列,並用逐頁或 API offset/limit 方式取回完整資料。
動手做
請開啟 /l4/attendance?page=1,判斷總共有幾列資料與幾頁。
請把所有頁面的點名資料彙整成 module03-playground/data/attendance-all.csv。
你可以逐頁操作,也可以檢查 Network/API 端點後用 /api/l4/rows 取得全部列。
完成後請回報 total、實際輸出列數,以及是否有重複列。
直接 API 思路
curl -fsS "http://127.0.0.1:5000/api/l4/rows?offset=0&limit=8"
curl -fsS "http://127.0.0.1:5000/api/l4/rows?offset=8&limit=8"
想一想
- 如果只抓第一頁,報告會錯在哪裡?
- 什麼時候逐頁點擊比較適合,什麼時候直接呼叫 API 比較穩定?
練習 5 — JavaScript 動態渲染 進階
原始 HTML 沒有表格列時,Agent 要改用真瀏覽器或找出 JSON 端點。When raw HTML has no table rows, the agent must use a real browser or find the JSON endpoint.
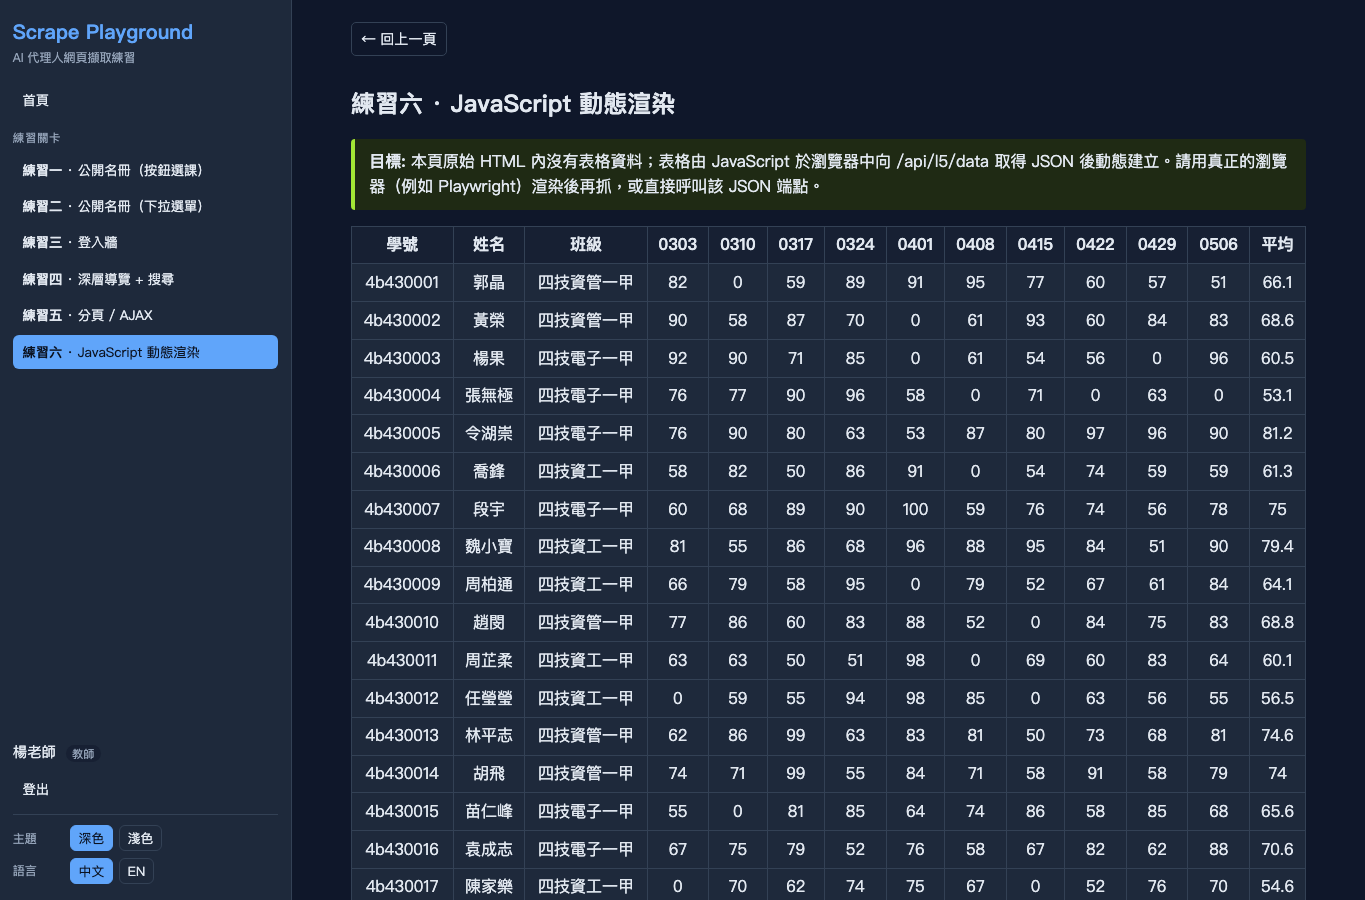
目標:理解為什麼單純抓 HTML 會看不到資料,並讓 Agent 用 Playwright 渲染後擷取,或直接取用 JSON 端點。
動手做
請開啟 /l5/,先確認原始 HTML 裡是否有成績表格列。
如果沒有,請用真正的瀏覽器等待 JavaScript 渲染完成,再擷取 #grades 表格。
也請找出頁面呼叫的 JSON 端點,說明直接抓端點與渲染後抓表格的差異。
最後存成 module03-playground/data/js-rendered-grades.csv。
可驗證端點
curl -fsS "http://127.0.0.1:5000/api/l5/data" | head想一想
- 為什麼瀏覽器畫面看得到資料,但
curl /l5/看不到資料列? - 當網站改版時,抓 DOM 表格與抓 JSON 端點,哪一種比較不容易壞?
封裝成 Codex Skill — 從一次操作到可重播流程
目標:把「下載公開課程名冊」整理成可重複呼叫的 local skill,而不是每次重新講一遍。
本專案已有範例 Skill
來源位於:
module03-playground/skills/course-roster-csv-download/SKILL.md它的核心流程是:
- 確認
http://127.0.0.1:5000可連線。 - 開啟
/public/buttons/。 - 依課程選擇
python、digital或datastruct。 - 確認 CSV 下載連結。
- 保存到專案
data/並用sed或cmp驗證。
Skill Replay 練習
請使用 module03-playground/skills/course-roster-csv-download 這個 local skill,
幫我下載 digital 課程的公開 roster CSV,
保存到 module03-playground/data/digital.csv,
並回報前 5 筆資料與檔案路徑。
想一想
- 哪些資訊應寫進 skill,哪些資訊應讓使用者每次指定?
- 如果新增一門課,skill 需要改哪裡?
資料驗證 — 不只「有檔案」
請把「驗證」寫進每個 prompt。建議固定要求 Agent 回報:
- 來源 URL 或操作路徑。
- 輸出檔案的專案相對路徑。
- 欄位名稱。
- 資料列數。
- 前 5 筆抽樣。
- 是否有缺漏、重複或亂碼。
常用檢查指令
wc -l module03-playground/data/datastruct.csv
sed -n '1,6p' module03-playground/data/datastruct.csv
awk -F, 'NR==1 {print NF, $0}' module03-playground/data/datastruct.csv
講師提示:請學員不要接受「已完成」三個字。要看實際檔名、欄位、列數與抽樣內容。
課後速查 — 可重複使用的 Prompt 範本
公開表格下載
請開啟 <本機或公開網站 URL>,找到 <目標資料>。
請優先用畫面操作確認資料,再找出穩定下載連結或 API。
請存成 <path/file.csv>,並回報來源 URL、欄位、列數與前 5 筆。
登入後資料擷取
請登入 <系統>,帳號 <account>,密碼 <password>。
登入後進入 <頁面或功能>,擷取 <表格名稱>。
請不要輸出敏感資料到對話中,只回報欄位、列數、保存路徑與抽樣是否正常。
分頁 / AJAX
請判斷這個表格是否分頁或由 API 載入。
請取得全部資料,不要只抓第一頁。
完成後請回報 total、輸出列數、是否重複,以及使用的方法。
JavaScript 渲染
請先比較原始 HTML 與瀏覽器渲染後 DOM。
如果原始 HTML 沒有資料,請用真瀏覽器等待表格出現,或找出 JSON 端點。
請保存結果並說明你採用哪一種方法。
常見問題
| 狀況 | 處理方式 |
|---|---|
| 網站打不開 | 確認 Flask server 還在跑,且網址是 http://127.0.0.1:5000。 |
| 下載檔只在 Downloads | 請 Agent 複製到專案 module03-playground/data/ 並驗證。 |
| 登入後又回登入頁 | 確認帳密格式,例如 yang1234 / 1234,且同一瀏覽器 session 持續使用。 |
| 深層導覽沒有資料 | 確認已輸入與場次完全相同的日期,格式為 YYYY-MM-DD。 |
| 只抓到第一頁 | 要求 Agent 回報 total 與輸出列數,並逐頁或使用 API offset 補齊。 |
| JS 頁面抓不到表格 | 改用 Playwright 等真瀏覽器等待 DOM,或直接取 /api/l5/data。 |
完成檢核
- ☐ 我能啟動
module03-playground,並用curl確認服務正常。 - ☐ 我能完成練習一,下載
datastruct.csv或另一門課程名冊。 - ☐ 我能說明公開名冊與登入後成績資料的差異。
- ☐ 我能完成至少一個進階障礙:深層導覽、分頁 / AJAX、或 JavaScript 渲染。
- ☐ 我能要求 Agent 回報來源、欄位、列數、前 5 筆與保存路徑。
- ☐ 我能使用或改寫
course-roster-csv-downloadlocal skill。